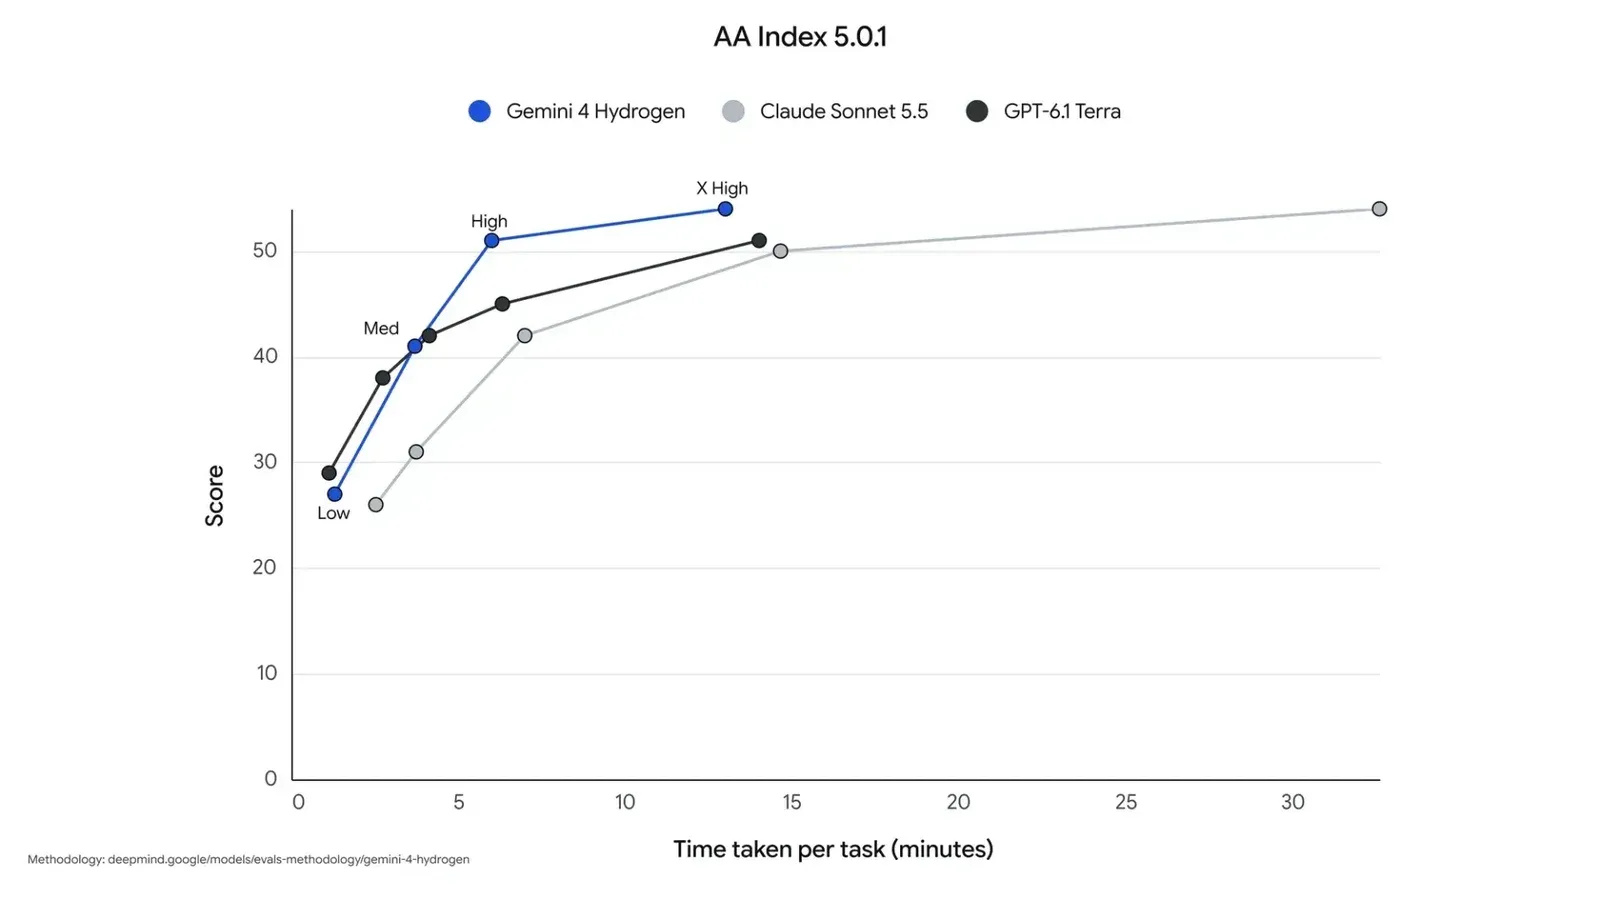
Gemini 4 Hydrogen obtuvo 54 puntos en el Intelligence Index de Artificial Analysis con su nivel de razonamiento extraalto. Quedó a un punto de Claude Sonnet 5.5 y GPT-6.1 Sol, ambos probados en su nivel máximo. La cercanía en la puntuación convive con diferencias de gasto: la firma calcula para Hydrogen un promedio ponderado de 3.16 dólares por tarea del índice, frente a 10.02 dólares para Sonnet y 1.27 para Sol.
Los importes corresponden a las tareas y configuraciones de esa evaluación, no a una tarifa fija por cada consulta que haga una persona. En la clasificación consultada el 13 de noviembre, el costo de Hydrogen equivale a cerca de un tercio del de Sonnet y a unas 2.5 veces el de Sol.
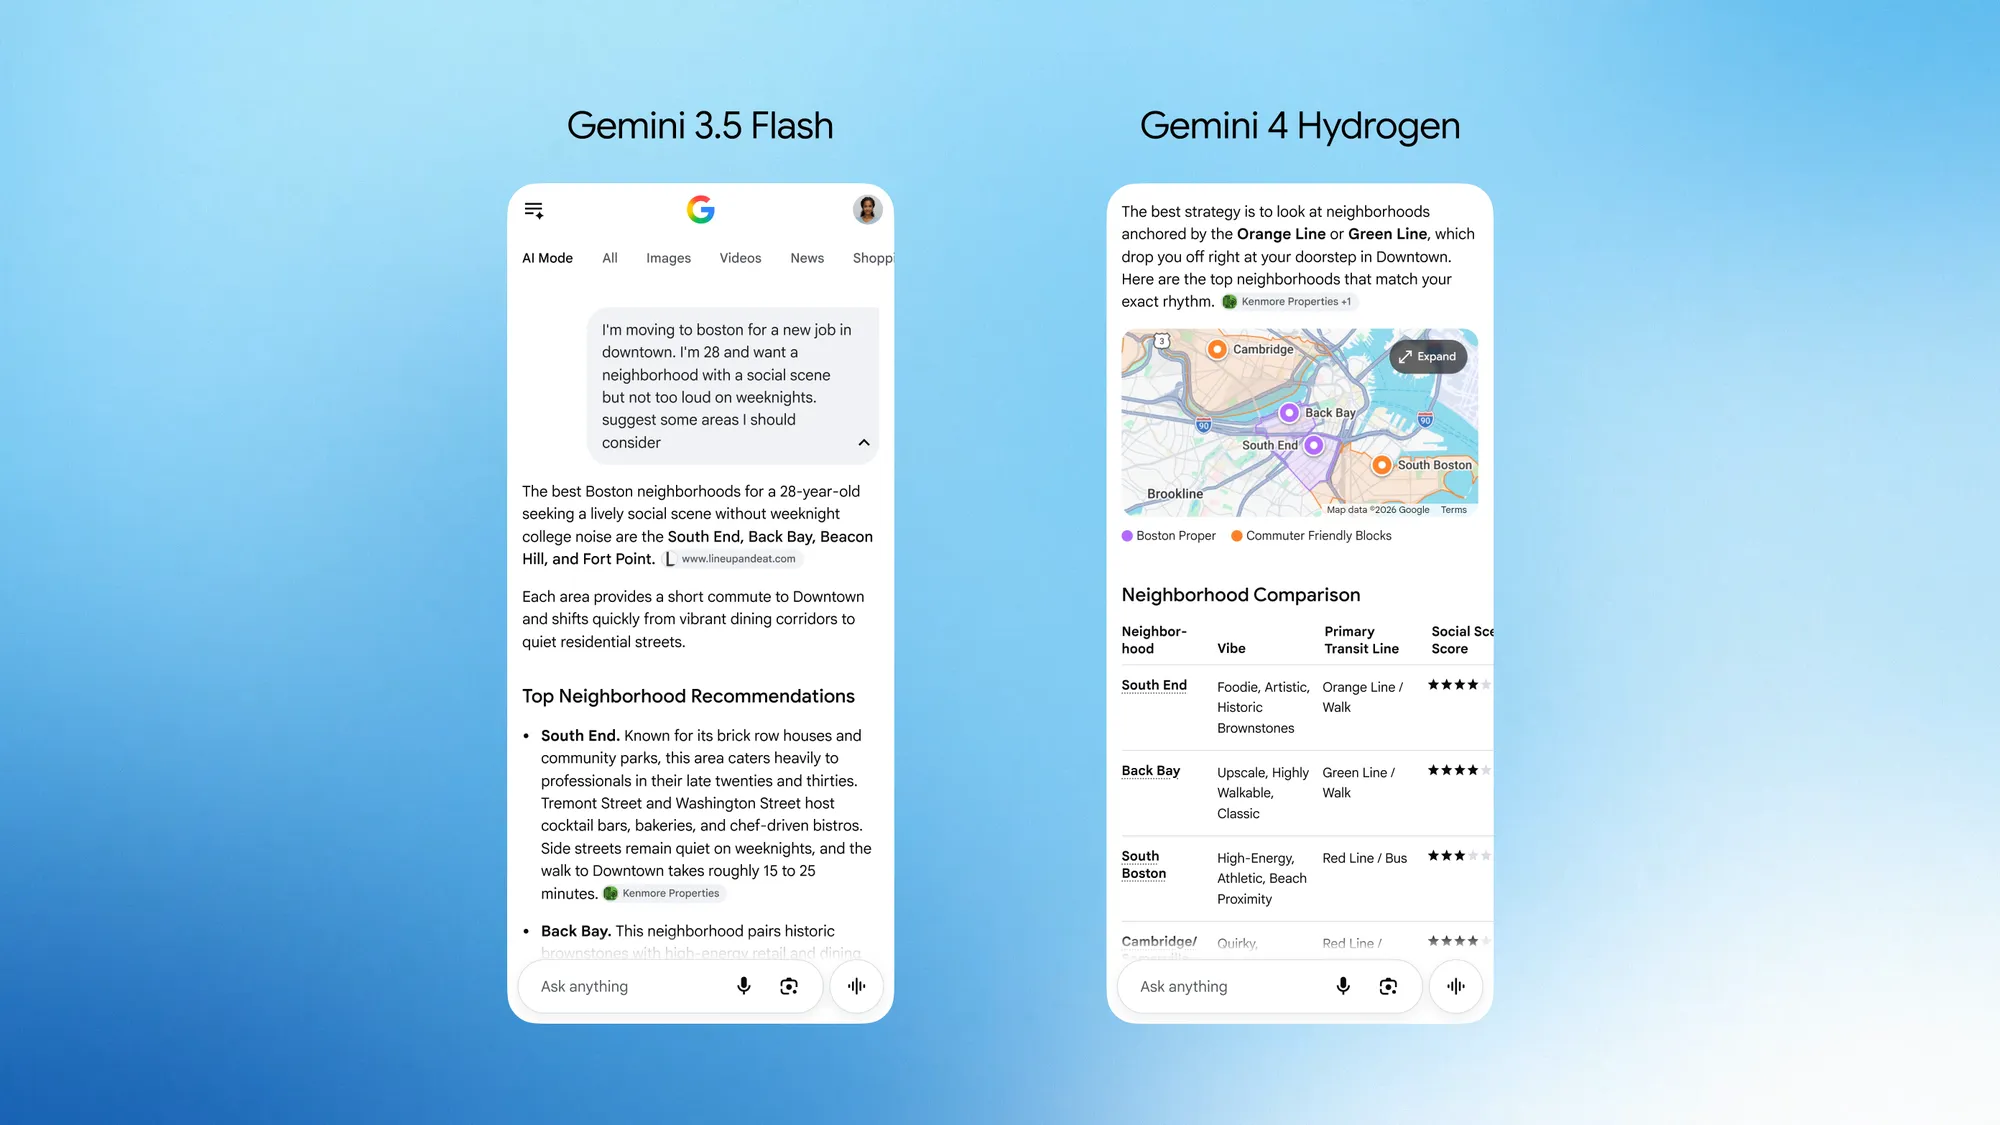
Google presentó Hydrogen el 12 de noviembre como un modelo para programación y flujos de trabajo con agentes. Su lanzamiento también llevó el modelo a Gemini y Search, además de las herramientas para desarrolladores.
 Gerardo Pavez
Qué cambia al subir el razonamiento
El ajuste usado modifica tanto la puntuación como el gasto. Según Google, Hydrogen ofrece cuatro niveles de razonamiento y usa "high" como predeterminado. Artificial Analysis le asigna 51 puntos y un costo medio de 1.87 dólares por tarea en ese nivel; con "xhigh" llega a 54 puntos y 3.16 dólares.
Eso supone cerca de 69 % más gasto por tarea del índice para obtener tres puntos adicionales en la escala redondeada. La clasificación de Artificial Analysis compara así las opciones, con los costos expresados en dólares estadounidenses:
| Modelo y nivel | Puntos | Costo por tarea |
|---|---|---|
| Gemini 4 Hydrogen (xhigh) | 54 | 3.16 dólares |
| Claude Sonnet 5.5 (max) | 55 | 10.02 dólares |
| GPT-6.1 Sol (max) | 55 | 1.27 dólares |
| Gemini 4 Hydrogen (high) | 51 | 1.87 dólares |
La comparación de 54 frente a 55 puntos usa las cifras redondeadas que muestra el índice. Describe la cercanía en esa batería, pero no demuestra que los modelos sean equivalentes en cada tipo de trabajo.
Precio por token frente a costo por tarea
Las tarifas estándar por unidad cuentan otra parte de la historia. Google cobra por Hydrogen 1.50 dólares por millón de tokens de entrada y 7.50 dólares por millón de tokens de salida. Para las API de Sol y Sonnet, Artificial Analysis muestra 2 dólares por millón de tokens de entrada y 10 dólares por millón de salida. OpenAI indica que las solicitudes a la API de Sol con más de 272,000 tokens de entrada tienen recargos.
Los tokens son unidades de información que los modelos procesan o generan. Si, a lo largo de varias solicitudes sujetas a las tarifas estándar, cada modelo recibiera en total un millón de tokens de entrada sin caché y generara 200,000 de salida, el cálculo sería de 3 dólares para Hydrogen y 4 dólares para cada uno de los otros dos. Es un ejemplo con consumos iguales y sin recargos, no una medición de una tarea real.
En una evaluación, los modelos no tienen por qué usar la misma cantidad de tokens. Artificial Analysis registró 304 millones de tokens de salida para Hydrogen en "xhigh" al ejecutar el índice, frente a 63.7 millones para Sol en "max". El costo ponderado también incorpora entradas y operaciones de caché, por lo que esos totales de salida, por sí solos, no explican toda la diferencia.
La firma calcula el costo de cada evaluación con los precios de los distintos tipos de tokens utilizados, lo divide por el número de tareas y lo pondera según el peso de esa evaluación en el índice. Los resultados pueden cambiar con la tarea, el proveedor y el consumo. Tampoco equivalen al precio de las suscripciones de Gemini, Claude o ChatGPT.
La puntuación general no cuenta todas las tareas
El Intelligence Index v5.0.1 reúne nueve evaluaciones en cuatro áreas de igual peso: trabajo de conocimiento, programación, ciencia y capacidades generales. La metodología de Artificial Analysis indica que la batería usa principalmente texto en inglés; el rendimiento multilingüe se evalúa por separado.
Los resultados de una prueba concreta muestran por qué conviene mirar más allá del total. En Terminal-Bench 4.0, que evalúa tareas realizadas mediante una terminal, la firma registró 53.5 % para Hydrogen en "xhigh", 56.1 % para Sol en "max" y 63.6 % para Sonnet en "max". Es una prueba dentro del índice y no representa toda la programación que pueden realizar los modelos.
Para un equipo que elija una API, la diferencia práctica dependerá de qué tareas quiera automatizar y cuántos recursos consuma cada modelo en ellas. La tabla ofrece una referencia común; una prueba con las solicitudes y los documentos del propio equipo permitiría contrastarla con ese uso.