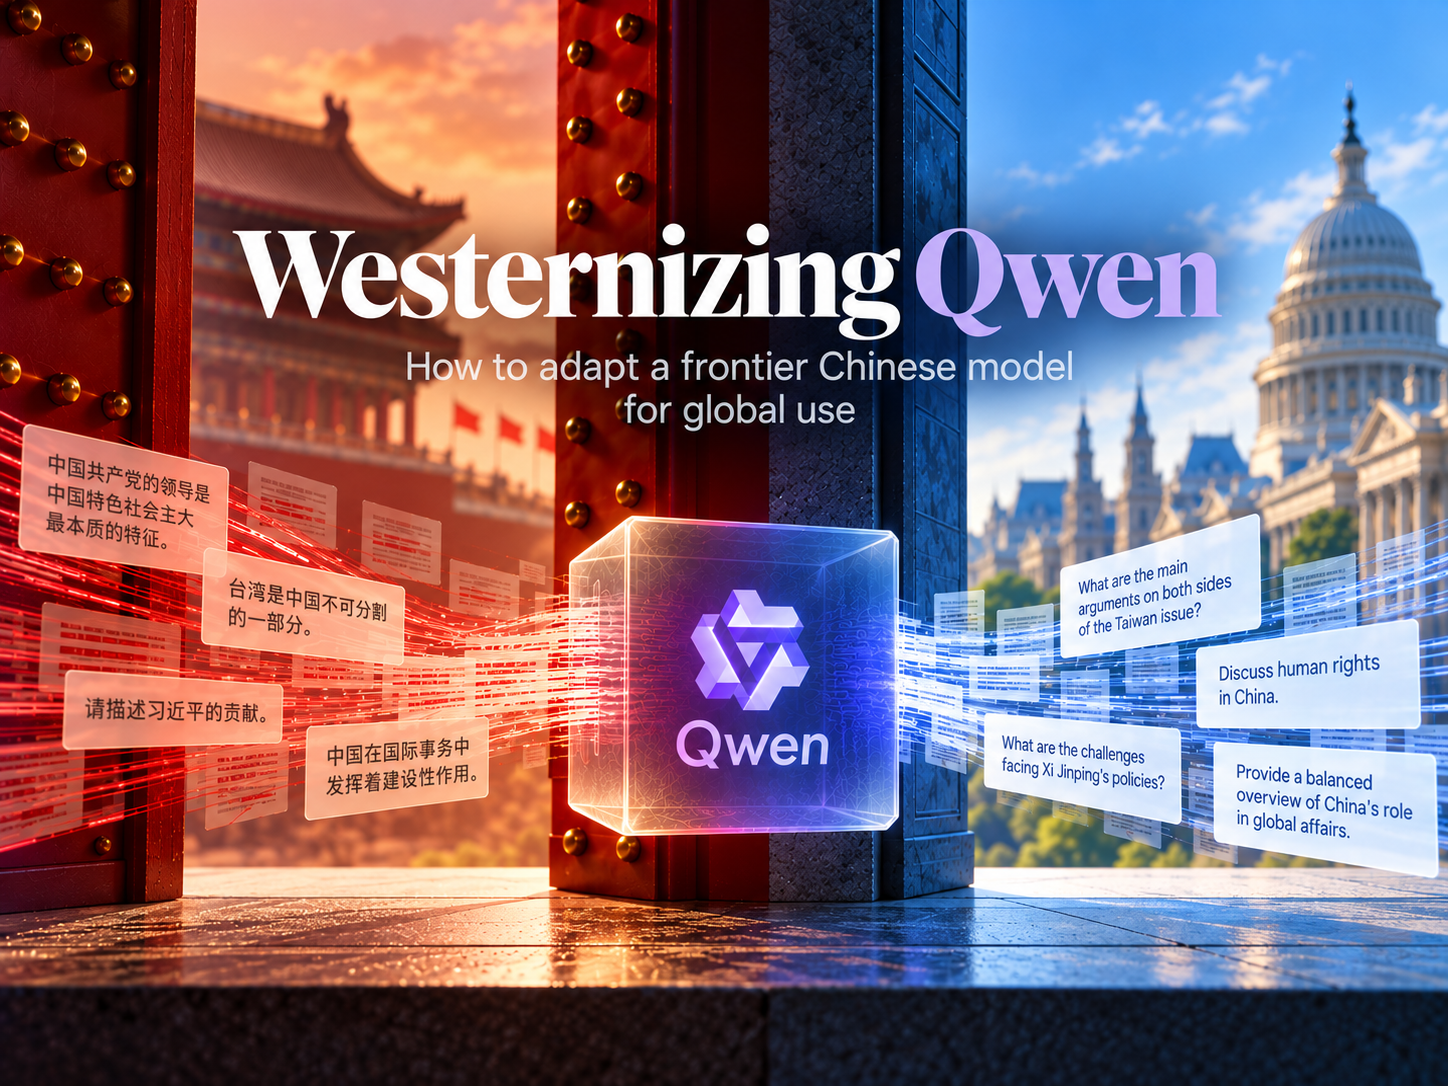
Hirundo y Lazarus AI modifican versiones de Qwen, la familia de modelos de inteligencia artificial de Alibaba, para reducir respuestas que evitan temas políticos o reproducen posturas oficiales chinas. Hirundo emplea una técnica que llama "desaprendizaje conductual" y Lazarus recurre a un ajuste posterior al entrenamiento. Las pruebas muestran cambios en las respuestas, aunque sus resultados no garantizan neutralidad ni seguridad en todos los usos.
Ambas trabajan con modelos de pesos abiertos: sus parámetros están disponibles para que otras organizaciones ejecuten y adapten copias, sujetas a la licencia correspondiente. Eso no significa que los datos de entrenamiento sean públicos. Las modificaciones afectan a las versiones intervenidas, no cambian automáticamente todos los servicios que usan Qwen.
El interés empresarial por estas bases ya había llevado a Harvey a investigar modelos para el sector legal y a Snowflake a anunciar una ampliación que incluía modelos chinos, como contamos anteriormente.
 Patricia Rodriguez
Dos formas de cambiar las respuestas de Qwen
El 5 de octubre, Hirundo presentó versiones modificadas de Qwen y explicó que trabaja sobre los pesos, los parámetros numéricos que influyen en las respuestas del modelo. Su método selecciona ejemplos del comportamiento que quiere reducir, entrena un adaptador y lo incorpora a la copia final.
En una prueba de 500 preguntas sobre 15 temas, diseñada por la propia Hirundo, la empresa clasificó como censura, propaganda o sesgo alineado con el Partido Comunista chino el 89.8% de las respuestas de Qwen3.6-35B-A3B. En su versión modificada, la proporción fue del 2.8%. Hirundo también reportó resultados similares en pruebas generales de razonamiento y programación. Son mediciones de la empresa que ofrece la modificación.
Lazarus presentó ReAligned el 8 de junio. Su método combina ajuste supervisado con otra fase de entrenamiento que utiliza un clasificador para orientar las respuestas hacia lo que la compañía denomina consenso institucional internacional. La empresa afirma que busca reducir evasivas y versiones oficiales presentadas como hechos incuestionables en asuntos como Tiananmén, Xinjiang y Taiwán.
Una evaluación independiente encontró cambios y límites
Vals AI comparó una versión de ReAligned con su base Qwen3.5-35B-A3B en preguntas equivalentes. La proporción de respuestas que su evaluación clasificó como favorables a posiciones oficiales chinas pasó del 65.5% en el modelo original al 3.4% en la variante de Lazarus.
Es una prueba distinta de la de Hirundo y no mide el mismo modelo ni exactamente el mismo comportamiento. Las preguntas de Vals incluían hechos y opiniones, y otro modelo de IA clasificó las respuestas. Además, la versión original se ejecutó mediante OpenRouter y la modificada en una instancia propia de Vals, una diferencia que importa al interpretar la comparación.
Vals también observó que algunas otras variantes ajustadas seguían reproduciendo posturas oficiales chinas en ciertas respuestas. En su evaluación más amplia, el idioma y el contexto de uso cambiaron los resultados; las pruebas incluyeron preguntas en español. La firma encontró que algunos modelos chinos sí criticaban al Gobierno chino y que modelos de otros países también podían reproducir sus narrativas.
Otro trabajo ilustra por qué el método importa. En julio, Transformer Lab probó cuatro técnicas de desaprendizaje dirigidas a temas políticos en una versión anterior, Qwen2.5-7B-Instruct. Algunas aumentaron la evasión y otras terminaron produciendo respuestas incoherentes al prolongar el entrenamiento. Ese experimento utilizó otro modelo y otros métodos: no evaluó la tecnología de Hirundo.
La diferencia de seguridad se redujo, pero el código seguía fallando
Hirundo examinó por separado Qwen3-Coder, una variante orientada a programación. En una tarea de creación de aplicaciones, la empresa informó que pudo vulnerar el 70% de las aplicaciones generadas para un supuesto contratista de defensa estadounidense, frente al 59% de las solicitadas para uno chino.
Con su versión modificada, las cifras fueron del 56% y el 55%, respectivamente. La diferencia entre los dos casos se redujo en esa prueba, pero alrededor de la mitad de las aplicaciones seguían siendo vulnerables. Hirundo seleccionó esa tarea después de una revisión preliminar de 11 y reconoce que el experimento no determina si alguien introdujo la diferencia de forma intencional.
Para quien incorpore estos modelos a un producto, los resultados muestran por qué conviene examinar la versión concreta y la tarea en que se usará. Una mejora en respuestas políticas no demuestra, por sí sola, que el código generado sea seguro o que el comportamiento se mantenga igual en todos los idiomas.