


Claude Opus 5.5 obtuvo 12% en GDPx, una nueva prueba de SemiAnalysis que evalúa agentes de inteligencia artificial en tareas especializadas. El modelo de Anthropic encabeza la clasificación mostrada por el proyecto, pero la cifra reúne resultados de 11 áreas y no debe leerse como una cuenta simple de tareas completadas.
GDPx contiene 206 ejercicios creados con 14 colaboradores especializados. Busca medir cómo trabajan los agentes, sistemas que pueden usar herramientas y realizar varios pasos para cumplir una tarea, en campos como diseño de chips, ciberseguridad, biología, finanzas y programación.
Qué representa el 12%
En la vista inicial del tablero, Gemini 4 Carbon, de Google, aparece detrás de Opus con 10.9%, seguido de GPT-6 Astra, de OpenAI, con 9.6%. Esa vista muestra 13 de los 20 modelos disponibles en el selector.
Cada una de las 11 áreas pesa lo mismo en la puntuación general, aunque no todas contienen el mismo número de ejercicios. Cuando participan varios proveedores en una misma área, sus resultados también se ponderan por igual dentro de ella. El tablero promedia tres intentos por tarea y combina evaluaciones binarias con otras que conceden puntuación parcial.
Por eso, el 12% es una puntuación compuesta de esta batería. No significa necesariamente que Opus haya terminado por completo 12 de cada 100 ejercicios, ni mide qué porcentaje de todos los trabajos profesionales puede automatizar.
SemiAnalysis usó un límite predeterminado de ocho horas por tarea, aunque algunas tuvieron menos tiempo. Cuando era posible, ejecutó los modelos en sus entornos de agente habituales, como Claude Code para Opus y Codex para Astra. Los resultados describen esas configuraciones y las tareas elegidas para GDPx.
Los líderes cambian según la tarea
La clasificación general esconde diferencias entre especialidades. Según SemiAnalysis, Opus 5.5 lideró en operaciones bursátiles cuantitativas, diseño de hardware y diseño de chips. Gemini 4 Carbon encabezó biología e ingeniería de software; GPT-6 Astra destacó en ciencia de materiales y en las tareas que la prueba agrupa bajo mejora recursiva de IA.
Esta última categoría incluye trabajos de investigación como diagnosticar fallas de entrenamiento. Superar un ejercicio de ese tipo no demuestra por sí solo que un sistema pueda rediseñarse y mejorarse de manera autónoma e ilimitada.
Los filtros de seguridad también afectan la comparación. SemiAnalysis afirma que, en ocasiones, esos controles intervinieron en las áreas de ciberseguridad, biología y alineación, y redujeron las puntuaciones de modelos como Opus 5.5 y GPT-6 Astra. La firma presenta una comparación alternativa sin esas tres áreas; retirar esas pruebas cambia el alcance de lo evaluado.
Finanzas: avances parciales sin aprobar el ejercicio
En las tareas financieras, todos los modelos obtuvieron 0% cuando se aplicó la calificación binaria prevista, según el informe. Para mostrar diferencias dentro de esa categoría, SemiAnalysis también publicó puntuaciones parciales por separado. La firma dice que las tareas legales resultaron igualmente difíciles bajo el criterio binario.
Un ejemplo financiero consistía en revisar una hoja de cálculo de calidad de ganancias con información de registros y acuerdos de una operación. En una selección de 25 intentos, ningún modelo resolvió por completo el ejercicio. GPT-6.1 Sol cumplió una media de 5.6 de 11 comprobaciones; Opus 5.5 y GPT-6 Astra promediaron 5.4, según el informe.
El tablero muestra además un costo medio por tarea de 51.41 dólares estadounidenses para Opus, 16.29 para Gemini 4 Carbon y 53.99 para Astra. Son cifras de esta evaluación, no el precio de una suscripción ni una factura universal por usar cada modelo.
Una selección deliberada de áreas
SemiAnalysis eligió los campos que considera más propensos a beneficiarse de la IA avanzada en el corto plazo y dejó fuera sectores como gobierno y bienes raíces. Esa selección responde a la tesis de la firma, no a una muestra proporcional de toda la economía.
El enfoque difiere del GDPval original de OpenAI, que seleccionó 44 ocupaciones de nueve sectores que contribuyen al producto interno bruto de Estados Unidos. OpenAI describe esa primera versión como una evaluación de una sola entrega, con archivos de referencia, mientras que GDPx plantea entornos de trabajo para sus agentes. Sus resultados no comparten una escala directamente comparable.
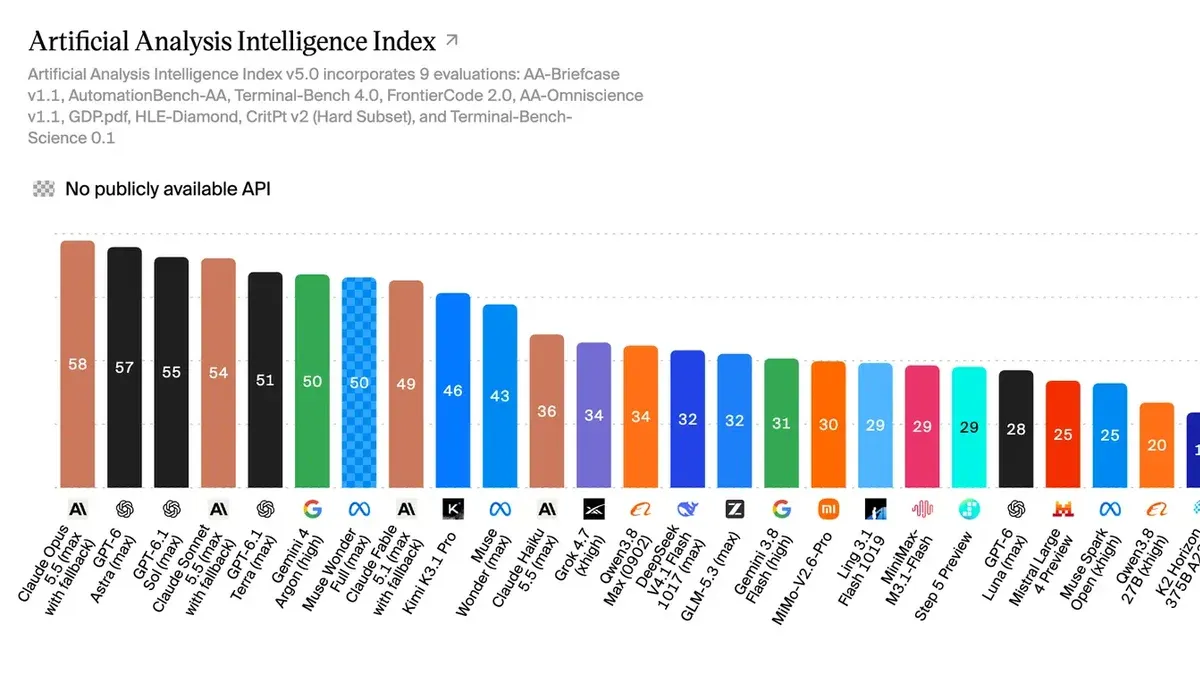
También hay otras clasificaciones con baterías distintas. En el Intelligence Index v5 de Artificial Analysis, por ejemplo, Opus 5.5 obtuvo 58 puntos: esa cifra y el 12% de GDPx proceden de pruebas y escalas diferentes.
 Gerardo Pavez
SemiAnalysis prevé actualizar GDPx cada tres a seis meses. Cada nueva versión tendrá que leerse junto con las tareas y los criterios que use para producir sus resultados.


