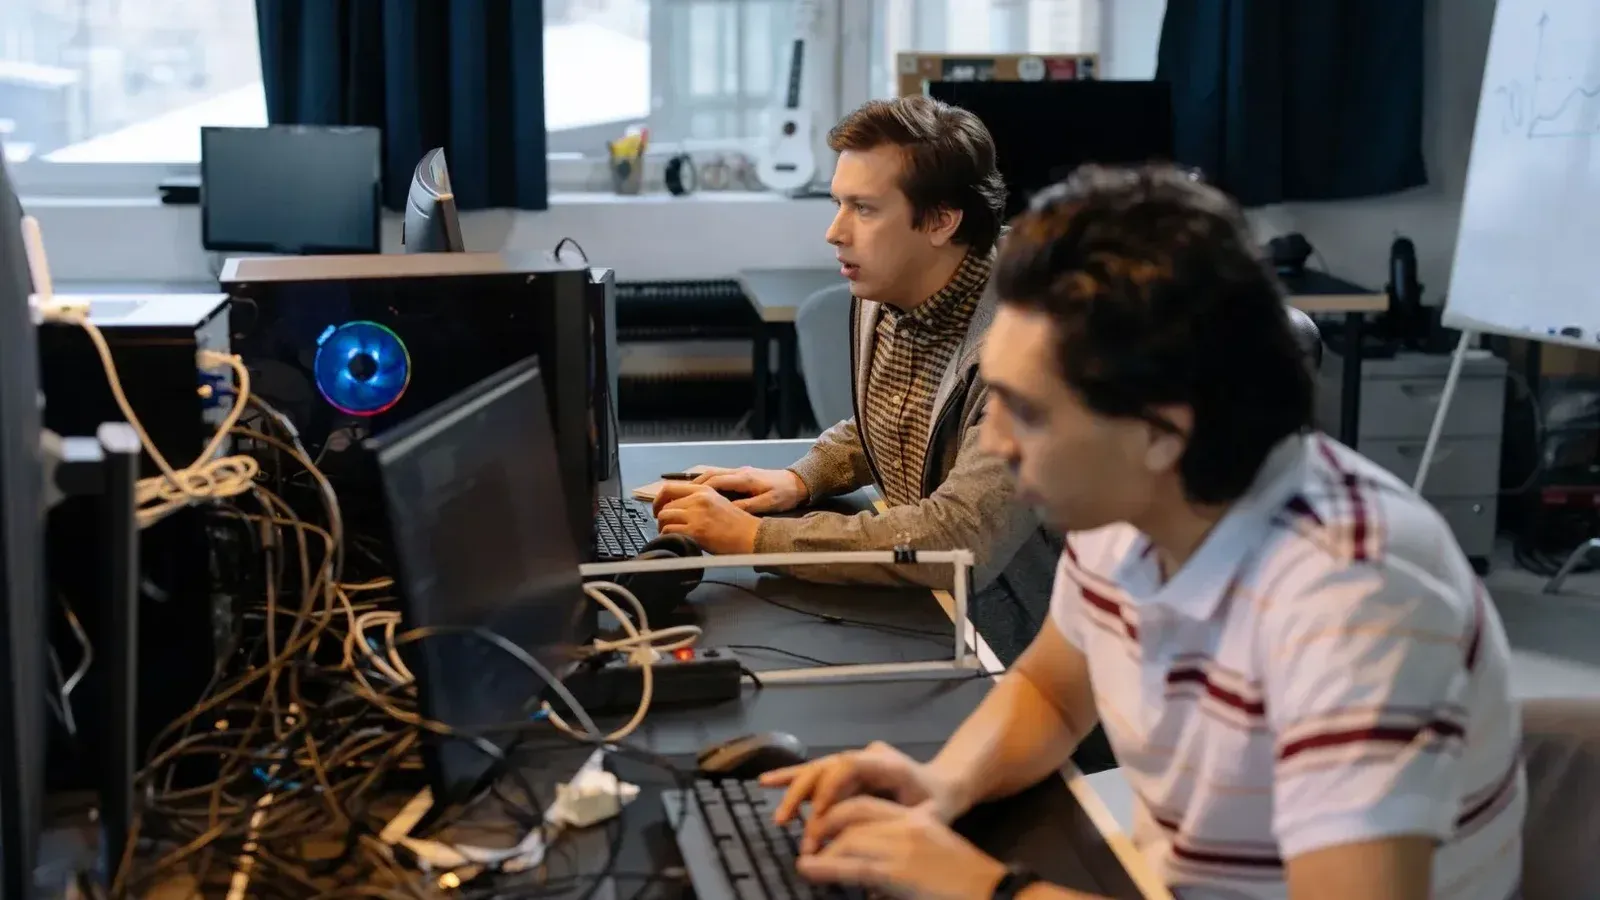
Microsoft atribuyó la caída mundial de Outlook y otros servicios de Microsoft 365 del 12 y 13 de noviembre a una combinación de factores que activó un defecto de software presente desde julio en sus servidores de conexión. La falla se extendió cuando el sistema intentó redistribuir el tráfico: en el peor momento, más del 80 % de los servidores de la pasarela afectada dejaron de responder.
La explicación aparece en un informe preliminar de Microsoft fechado el 15 de noviembre, cuya copia publicó la consultora 365Fanatic. El documento identifica a Exchange Online, el servicio que aloja buzones y al que accede Outlook, como el más afectado. Muchas personas no podían abrir su correo y otras experimentaron retrasos en la entrega de mensajes.
El reporte sitúa el periodo de impacto entre el 12 y el 13 de noviembre, durante 23 horas y 50 minutos. La gravedad cambió según la región, la forma de conexión y el momento; no implica que cada usuario haya permanecido sin servicio durante todo ese periodo.
Microsoft ya había dado por restablecidos los servicios tras una recuperación gradual y una vigilancia adicional del correo acumulado.
 Gerardo Pavez
Cómo una medida de recuperación extendió la falla
La pasarela de red recibe y encamina conexiones hacia varios servicios de Microsoft 365. Cuando uno de sus servidores deja de responder, la infraestructura suele enviar las solicitudes a otros equipos disponibles para mantener el acceso.
Durante este incidente, esas conexiones trasladaron más carga a los servidores restantes, que también tenían el defecto. Las solicitudes se acumularon y la falla pasó de un equipo a otro. Microsoft dice que el problema se propagó por su infraestructura de pasarela en menos de dos horas.
La cifra superior al 80 % se refiere a los servidores de esa pasarela que quedaron sin respuesta en el momento más crítico. El informe no la presenta como una proporción de usuarios afectados.
La empresa señaló que, por otro problema, las divisiones diseñadas para contener fallas entre grupos de capacidad tampoco detuvieron la propagación. El documento preliminar no detalla la causa de ese segundo problema.
El cambio de julio y la carga de Teams
El defecto procedía de una corrección preparada para los servidores de conexión de Microsoft 365. Su despliegue empezó en julio y se extendió gradualmente por la infraestructura mundial, donde funcionó más de tres meses sin que se observara el problema, según la compañía.
Microsoft explicó que, bajo determinadas condiciones de carga, varias tareas competían por recursos dentro de un proceso de Windows. Esa disputa podía agotar el procesador y la memoria hasta dejar al servidor sin respuesta. La empresa precisa que tanto el defecto como la corrección se limitan a esos servidores y no se aplican a las instalaciones generales de Windows.
Las pruebas habituales no lo detectaron. De acuerdo con el informe, el laboratorio utilizaba una combinación distinta de tráfico y equipos, y tendía a probar máquinas menos potentes y con menos núcleos. El problema se agravaba en hardware más reciente y con más núcleos.
Unas 15 horas antes de la interrupción, un mecanismo automático trasladó el tráfico de Teams desde una pasarela alternativa hacia la principal, compartida con Exchange Online. Esa operación forma parte de los procedimientos normales de disponibilidad, pero cambió el patrón de tráfico y aumentó la carga en la pasarela principal.
Al mismo tiempo, casi el 14 % de la capacidad de servidores de esa pasarela estaba fuera de servicio por un problema distinto ocurrido el día anterior. Microsoft sostiene que la capacidad restante habría sido suficiente por sí sola; fue la combinación de esa reducción, el cambio de carga y el defecto latente la que desencadenó la falla.
Por qué el correo tardó más en volver
Teams, OneDrive, SharePoint y aplicaciones de Office pudieron desviar parte de su tráfico fuera de la infraestructura afectada y se recuperaron parcialmente antes. Microsoft indicó que Exchange Online no podía abandonar esa pasarela de la misma manera por razones de escala.
Los reinicios tampoco resolvían el problema de forma duradera: cuando los servidores volvían a recibir las conexiones pendientes, podían saturarse y dejar de responder otra vez. La compañía añadió que sus mecanismos habituales de reversión no permitían retirar rápidamente un defecto que llevaba meses desplegado.
Los ingenieros prepararon una actualización para devolver el código de gestión de conexiones a un estado anterior que funcionaba. Para aplicarla, retiraron grupos de servidores, instalaron el cambio, los reiniciaron y los reincorporaron gradualmente. Microsoft también añadió capacidad y amplió el plazo de entrega del correo para procesar los mensajes que habían quedado en espera.
El informe sigue siendo preliminar y puede cambiar. Microsoft prevé entregar una lista completa de medidas correctivas el 20 de noviembre como parte de su revisión final. Los administradores pueden consultar los incidentes EX1550543 y MO1550821 en la sección Health > Service health del centro de administración de Microsoft 365.
 Patricia Rodriguez