


Microsoft presentó el 12 de octubre Azure Maia 300, su tercera generación de chips para inteligencia artificial, cuyo despliegue en producción comenzará en 2027. La compañía planea convertir la familia Maia en la principal plataforma de inferencia de sus productos y servicios.
La inferencia es el trabajo que realiza un modelo ya entrenado al responder una solicitud. Como explica Google Cloud, generar una respuesta exige menos cómputo que entrenar el modelo, pero atender millones de solicitudes requiere infraestructura optimizada. Ese uso cotidiano es el que Microsoft busca trasladar a su propio hardware.
Qué significa producir más tokens por megavatio
Microsoft espera que Maia 300 genere 40 % más de tokens por megavatio que los principales sistemas basados en GPU. Los tokens son las unidades de texto que procesan y generan los modelos; la comparación relaciona su producción con la potencia eléctrica utilizada.
Si esa mejora se cumpliera con una carga de trabajo comparable, durante el mismo tiempo, la energía necesaria por token sería aproximadamente 28.6 % menor. El cálculo divide el consumo por unidad de trabajo entre 1.4. Es una equivalencia matemática condicional del anuncio; convertirla en ahorro económico exigiría conocer también los costos de operación.
Reuters señaló que Microsoft no identificó los sistemas GPU usados como referencia. Esa omisión limita la comparación con equipos concretos de Nvidia o AMD y deja pendiente conocer las condiciones de las pruebas.
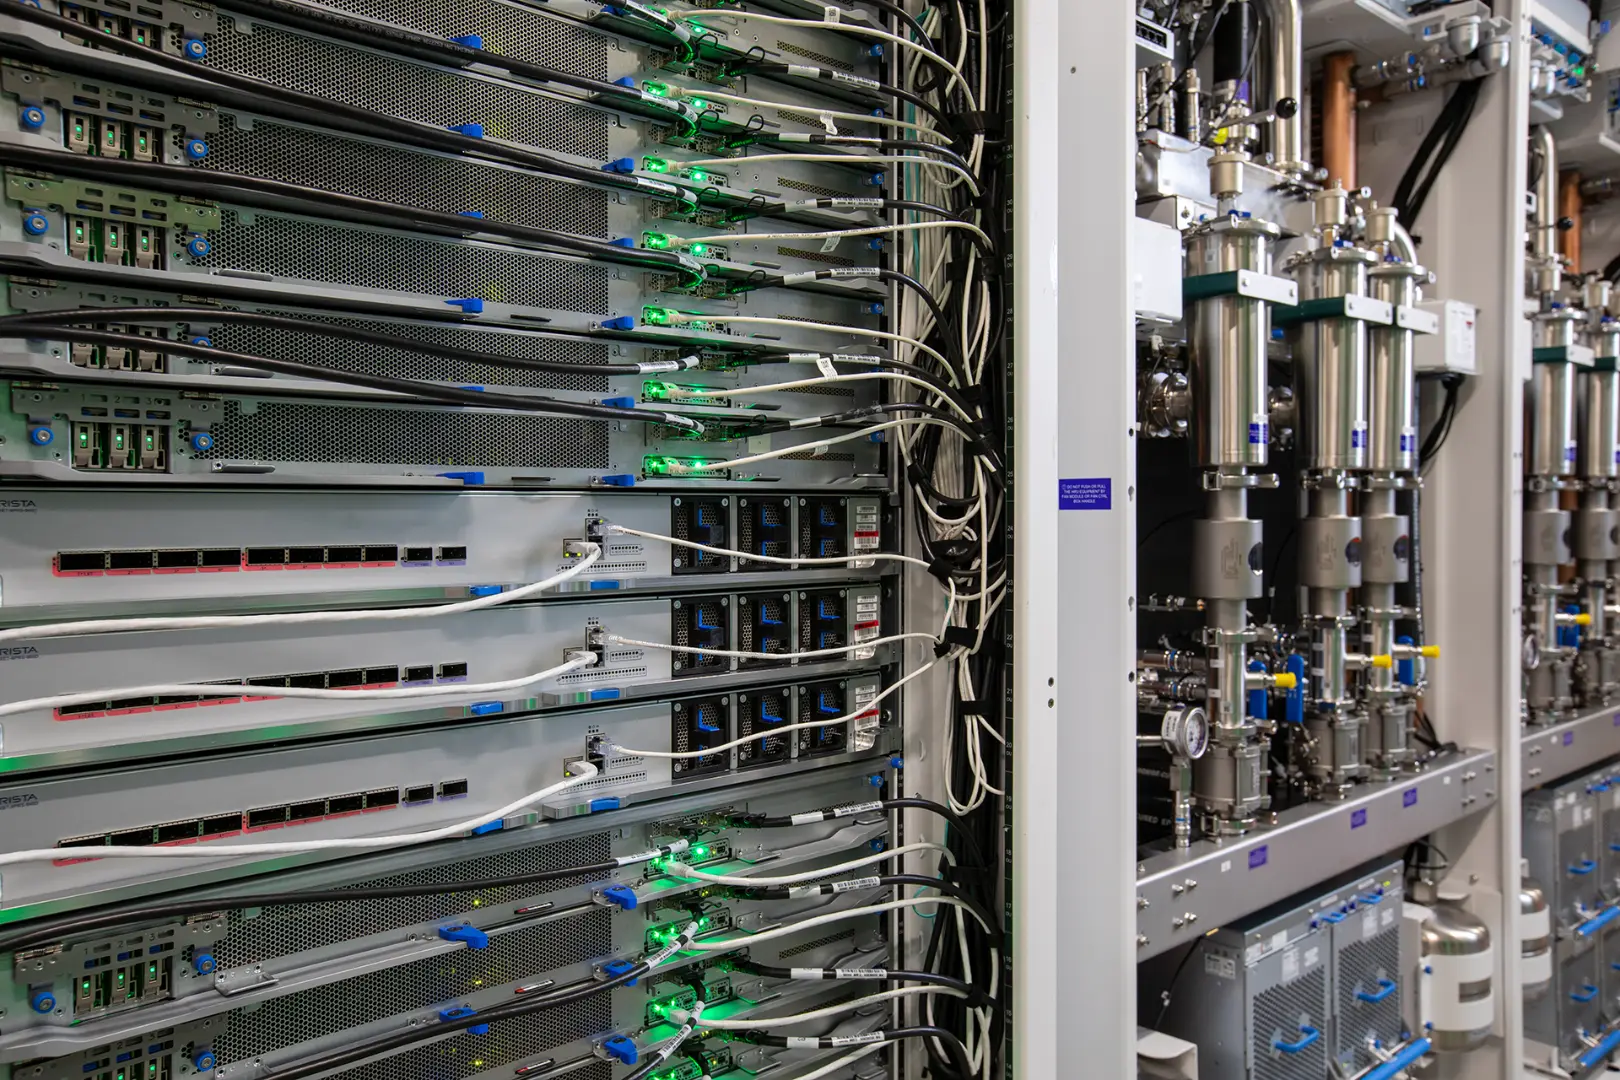
Otra cifra del anuncio tiene una base distinta: Microsoft atribuye a Maia 300 hasta siete veces la producción de tokens por rack frente a Maia 200. La documentación técnica precisa que el nuevo rack pasa de 48 a 96 aceleradores. El salto reúne mejoras de arquitectura y el doble de chips trabajando juntos; describe el sistema completo.
N2P y más memoria para conversaciones largas
Maia 300 divide las funciones de cómputo, control de memoria y entrada y salida entre pequeños chips integrados, llamados chiplets. Microsoft utiliza el proceso N2P de TSMC para los chiplets de cómputo, donde busca obtener la mayor mejora de rendimiento por vatio.
La ficha técnica detalla ocho pilas de memoria HBM4 por acelerador, con 288 GB de capacidad y un ancho de banda máximo de 18 TB/s. Esta última cifra mide la velocidad de transferencia de datos, un factor relevante cuando los modelos deben acceder a grandes cantidades de información para generar respuestas.
Microsoft también diseña el software para colocar los datos cerca del componente que los utiliza y reducir su movimiento. La apuesta combina memoria, cómputo y red para sostener conversaciones extensas y tareas de agentes que requieren varios pasos.
Copilot ya usa Maia 200
La transición parte de una generación que ya está en producción. Según el comunicado oficial, Maia 200 atiende Microsoft Copilot y ejecuta modelos de OpenAI, de Microsoft y de código abierto. GitHub Copilot y Microsoft Foundry se incorporarán antes de terminar 2026.
GeekWire señala que Maia todavía no está disponible para que clientes externos alquilen sus aceleradores. El medio también recuerda que Nvidia sigue siendo proveedor de los centros de datos de Microsoft. La prioridad anunciada para la inferencia convive, por tanto, con infraestructura de otros fabricantes.
Microsoft ampliará los detalles de su estrategia durante Ignite, en noviembre de 2026. Para Maia 300, el siguiente paso anunciado es llevar esa arquitectura a cargas reales de producción y comenzar la expansión de la familia Maia a varios gigavatios de capacidad eléctrica en 2027.


